Настройка сети Proxmox: MikroTik и серверы Supermicro
Сервер Supermicro с быстрыми NVMe может упираться в сеть раньше, чем в процессор. Коммутатор MikroTik с портами 100G при этом способен работать почти без нагрузки: достаточно подключить хост через гигабитный разъём управления, ошибиться с VLAN или отправить основной поток через неподходящий программный маршрут. Поэтому проект сети Proxmox начинают с пути данных между приложением, виртуальной машиной, сетевой картой, коммутатором и хранилищем.
Для небольшой виртуальной инфраструктуры обычно рассматривают 10G и 25G на сервер, а 100G используют для агрегации, подключения быстрого хранилища или более нагруженных узлов. Выбор меняется, когда появляются распределённое хранение, параллельные миграции ВМ, ночные резервные копии и требование пережить отказ коммутатора. Порт с высокой скоростью решает лишь часть этих задач. Остальные требуют правильных мостов, тегов, маршрутов, резервирования и измерений.
Здесь разобран общий проект для трёх серверов Supermicro и коммутаторов MikroTik: как выбрать скорость, разделить трафик, настроить связку RouterOS и Proxmox VE, проверить физическую совместимость и принять сеть до переноса рабочих ВМ. Примеры адресов и расчётов условные. Они помогают подготовить собственную схему и техническое задание; полученные в своей инфраструктуре показатели нужно записывать отдельно.
Что именно должна решать сеть между MikroTik и Supermicro?
Начните с трёх вопросов: какие данные передаются, между какими узлами и за какое время они должны пройти. Запись «нужен коммутатор для трёх серверов» не определяет даже минимальную скорость. Три сервера с локальными дисками и редкими резервными копиями создают совсем другой профиль, чем три узла с общим распределённым хранилищем. В первом случае основной обмен может идти к пользователям, во втором большая часть нагрузки останется внутри серверной стойки.
Зафиксируйте обычный рабочий день и два тяжёлых режима: обслуживание и отказ. Во время обслуживания один хост освобождают, виртуальные машины переносят на оставшиеся, а резервное копирование продолжает работать. При отказе диска или узла хранилище может начать восстановление копий. Если рассчитать сеть только по средней загрузке в середине дня, эти режимы окажутся за пределами проекта. Именно тогда пользователи увидят зависшие приложения при вполне исправных процессорах и SSD.
Полезный результат первого этапа — перечень потоков с источником, получателем, средней и пиковой скоростью, допустимой задержкой и временем выполнения. Для резервного копирования укажите объём изменённых данных и окно. Для миграции — объём памяти ВМ, способ размещения дисков и допустимую паузу. Для приложений — число одновременных клиентов и характер операций. Размер файла, число операций ввода-вывода и интенсивность изменения памяти объясняют поведение сети лучше, чем одно значение «скорость сервера».
Дальше определите границу ответственности устройств. Proxmox создаёт виртуальные сетевые интерфейсы и соединяет ВМ с мостами хоста. MikroTik передаёт кадры между физическими портами и, при выбранной архитектуре, маршрутизирует между подсетями. Сервер Supermicro предоставляет процессор, память, PCIe, сетевые контроллеры и отдельные средства управления. Эти роли согласуются в одном проекте. Названия брендов сами по себе не задают совместимость всех компонентов и готовность системы к отказам.
Не назначайте одной статье или одному устройству все задачи инфраструктуры. Подбор лицензии виртуального маршрутизатора, сравнение домашних роутеров, расчёт офисного Wi-Fi и выбор NAS имеют свои критерии. В серверной связке основной вопрос другой: как обеспечить нужный обмен между хостами и внешними сетями в штатном и аварийном режимах. Поэтому ниже центральное место занимают физические интерфейсы, мосты, VLAN, хранилище и проверяемые сценарии отказа.
Какие виды трафика Proxmox нужно разделить?
В одной стойке удобно выделить управление гипервизорами, пользовательский трафик виртуальных машин, миграцию, обмен с хранилищем, резервное копирование и служебную связь кластера. Это логические роли. Шесть ролей не означают обязательные шесть сетевых карт на каждый узел: часть потоков может проходить через общий быстрый интерфейс. Но каждый такой общий участок становится местом конкуренции за полосу и потенциальной общей точкой отказа.
Веб-интерфейс Proxmox и SSH не требуют десятков гигабит. Для них важнее доступность и возможность восстановить управление при ошибке основного моста. Пользовательские ВМ могут передавать мелкие запросы к базе данных или большие файлы, и одинаковые по размеру виртуальные серверы создают разную сетевую нагрузку. Миграция потребляет полосу короткими интенсивными интервалами. Резервное копирование создаёт длительный поток и часто совпадает с другими ночными задачами.
Corosync, который участвует в связи узлов Proxmox, чувствителен к задержке и потере пакетов. Ему обычно хватает выделенного гигабитного интерфейса, если соединение стабильно. Размещать этот обмен в одной неконтролируемой очереди с восстановлением больших объёмов Ceph рискованно: VLAN изолирует логическую сеть, но не резервирует физическую пропускную способность. Для резервирования Corosync используют дополнительные связи через другой физический путь и проверяют, что отказ одного сегмента действительно оставляет второй.
IPMI/BMC сервера — ещё одна отдельная роль. Это доступ к аппаратному управлению, который может сохраняться при неработающей ОС. Адрес BMC не заменяет адрес Proxmox, а выделенный разъём BMC не превращается в интерфейс пользовательских ВМ. У некоторых плат возможен shared LAN, поэтому расположение и режим конкретного разъёма нужно определить до монтажа. Подпись кабеля «управление» без уточнения получателя здесь слишком расплывчата.
| Поток | Что определяет требования | Что проверять в первую очередь |
|---|---|---|
| Управление Proxmox | Доступность панели и SSH | Адрес хоста, маршрут, доступ администратора |
| Трафик ВМ | Приложения и число клиентов | Нужный VLAN, шлюз, задержка и скорость |
| Миграция | Память ВМ, изменения памяти, перенос дисков | Выделенный путь и время переноса под нагрузкой |
| Хранилище | Тип дисков, репликация, восстановление | Пропускная способность и задержка в тяжёлом режиме |
| Corosync | Стабильность обмена между узлами | Задержка, потери, независимость резервного пути |
| IPMI/BMC | Аппаратное управление и восстановление | Отдельный доступ при недоступной ОС |
Удобно дать каждому потоку владельца и критерий готовности. Например, системный администратор проверяет миграцию тестовой ВМ, сетевой инженер — разрешённые VLAN и резервный путь, специалист по резервному копированию — полное восстановление. Это предотвращает ситуацию, когда коммутатор принят по зелёным индикаторам, а приложения никто не запускал. Для небольшой команды роли могут совмещаться, но перечень проверок от этого не сокращается.
10, 25 или 100G: как рассчитать скорость для серверов?
Сетевые скорости обозначают в битах в секунду. Восемь бит составляют один байт, поэтому 10 Гбит/с соответствуют 1,25 ГБ/с до учёта служебного обмена, 25 Гбит/с — 3,125 ГБ/с, 100 Гбит/с — 12,5 ГБ/с. Это верхняя арифметическая граница, а не обещание скорости копирования файла. Полезный результат дополнительно ограничивают Ethernet, IP и TCP, размер пакетов, процессорные затраты и работа приложения.
Для предварительного расчёта времени используйте формулу: объём в байтах, умноженный на восемь, разделить на скорость в битах в секунду. Если передавать десятичный 1 ТБ без каких-либо накладных расходов, получится 800 секунд на 10G, 320 секунд на 25G и 80 секунд на 100G. Для сравнения вариантов этого достаточно. Для окна обслуживания нужна измеренная полезная скорость на собственных серверах, а также время подготовки и завершения операции.
Смешивать ТБ и ТиБ нельзя. Один ТиБ равен 1 099 511 627 776 байтам и примерно на 9,95% больше десятичного терабайта. Если программа показывает ТиБ, а расчёт сделан для ТБ, оценка времени окажется заниженной уже до любых сетевых потерь. Точно так же 128 ГиБ оперативной памяти — это 137 438 953 472 байта. Эти различия особенно заметны при коротких окнах миграции и копирования.
| Скорость линии | Предел до накладных расходов | Идеальное время передачи 1 ТБ | Типичный повод рассматривать |
|---|---|---|---|
| 1G | 125 МБ/с | 2 ч 13 мин 20 с | Управление, небольшие служебные потоки |
| 10G | 1,25 ГБ/с | 13 мин 20 с | Умеренная серверная нагрузка, первые быстрые соединения |
| 25G | 3,125 ГБ/с | 5 мин 20 с | Несколько параллельных потоков, миграция, SSD-хранилище |
| 100G | 12,5 ГБ/с | 1 мин 20 с | Агрегация нескольких узлов и быстрые системы хранения |
| 400G | 50 ГБ/с | 20 с | Специализированные вычислительные и высокоскоростные сети |
Следующий шаг — сложить одновременные потоки на конкретном направлении. Допустим, узлу одновременно нужны 8 Гбит/с для ВМ, 6 Гбит/с для миграции и 4 Гбит/с для резервного копирования. Получается 18 Гбит/с. На одном 10G-порту такой режим не помещается. На 25G остаётся 7 Гбит/с до номинального предела, однако часть этого остатка уйдёт на служебный обмен и колебания нагрузки. Если хранилище добавит ещё 10 Гбит/с, придётся менять расписание, разделять интерфейсы или повышать скорость.
Считайте входящее и исходящее направления отдельно: Ethernet full duplex передаёт данные одновременно в обе стороны. Указанные в характеристиках коммутатора большие суммарные числа нередко учитывают обе стороны всех портов. Нельзя взять такую сумму и считать её скоростью одного подключения. Для трёх серверов с одним активным 25G-портом на каждом максимальный суммарный исходящий поток хостов составляет 75 Гбит/с. Но если все данные направлены в одно 25G-хранилище, его интерфейс станет общим ограничением.
Не резервируйте запас по одному произвольному проценту. Для интерактивных приложений запас нужен, чтобы краткие всплески не превращались в длинную очередь. Для миграции требуется завершить перенос в заданное окно. Для системы, которая должна пережить отказ одного линка, рабочая нагрузка должна помещаться в оставшийся путь. Иногда два порта по 25G нужны ради устойчивости, хотя обычная нагрузка ниже 10G. В другом проекте один 100G-порт ускоряет работу, но оставляет недопустимую точку отказа.
Какой коммутатор MikroTik подходит для серверной сети?
Выбирайте коммутатор по числу серверных подключений, скорости каждого пути и резерву на расширение. Для 10G-сети с оптическими или DAC-соединениями можно рассматривать CRS317-1G-16S+RM: у него 16 портов SFP+ 10G. Для перехода к 25G полезен CRS510-8XS-2XQ-IN с восемью SFP28 25G и двумя QSFP28 100G. CRS518-16XS-2XQ-RM увеличивает число SFP28 до 16 при двух QSFP28. Это разные портовые бюджеты, которые нужно сопоставлять со схемой, а не только с сегодняшним числом серверов.
У трёх хостов с двумя подключениями на каждом шесть оконечных портов. Если оба соединения приходят в один CRS510, из восьми SFP28 останутся два. При разнесении по двум коммутаторам на каждом используются три SFP28, а дополнительно нужны межкоммутаторные связи и выход в остальную сеть. Подключение отдельного хранилища, сервера резервного копирования и тестового узла может быстро изменить эту арифметику. Составьте таблицу портов до заказа оборудования.
Для подбора сравнивайте коммутаторы MikroTik с нужным типом разъёмов. Переход на 25G предполагает SFP28 на соответствующих соединениях, а 100G часто использует QSFP28. Наличие одного быстрого uplink не означает, что все серверные порты имеют такую же скорость. Точно так же QSFP+ 40G и QSFP28 100G нельзя считать одинаковыми только из-за похожей формы корпуса модуля.
У коммутатора есть отдельный управляющий процессор и коммутационная микросхема. Пересылка кадров внутри поддерживаемой аппаратной схемы и программная обработка сложного firewall — разные нагрузки. Модель с быстрыми портами может отлично передавать серверный L2-трафик и значительно медленнее обрабатывать поток, который проходит через CPU. Поэтому полосу для хранения и миграции стараются не заводить в случайный программный маршрут. Нужные функции проверяют вместе с режимом аппаратного ускорения.
Смотреть только на частоту процессора CRS тоже недостаточно. В серверном проекте проверьте поддержку VLAN filtering с аппаратной коммутацией, доступные режимы агрегации, возможности мониторинга, резервирование питания и выбранную версию RouterOS. Если нужен MLAG, отдельно проверяется его совместимость с другими функциями. В частности, MLAG и L3 hardware offloading имеют ограничения совместного использования. Нельзя взять максимальную производительность каждой функции из разных режимов и объединить её в одну гарантированную конфигурацию.
Не переносите измерения из видеоролика на свой объект. Низкое потребление коммутатора без подключённых модулей не равно мощности полностью укомплектованной стойки. Реальное энергопотребление, шум и температура меняются с трансиверами, вентиляцией и нагрузкой. На этапе подбора полезно сверить максимальные паспортные значения, а при приёмке записать фактический режим с установленными кабелями и оптикой. Цена и наличие проверяются при заказе, а не по историческому обзору.
Что проверить в сервере Supermicro до покупки сетевой карты?
Начните с точной модели платы и серверной платформы. У внешне похожих Supermicro могут различаться контроллеры LAN, электрическая разводка PCIe, райзеры, число свободных слотов и охлаждение. Например, H13SSL-NT имеет два встроенных порта 10GBase-T на Broadcom BCM57416 и отдельный гигабитный порт IPMI. Это медные RJ45-подключения. Для прямого соединения с SFP28-портом 25G потребуется подходящий дополнительный сетевой адаптер, а не обычный медный патч-корд.
Сетевые карты и адаптеры Supermicro подбирают по интерфейсу хоста, форм-фактору и конкретному контроллеру. Пример двухпортового 25G-адаптера — AOC-S25G-b2S: Broadcom BCM57414, два SFP28, PCIe 3.0 x8, стандартное низкопрофильное исполнение. Такой набор характеристик позволяет начать проверку совместимости. Он не заменяет сверку списка поддерживаемых компонентов конкретной системы, версии прошивки и доступного охлаждения.
Размер разъёма PCIe и число работающих линий различаются. Карта может физически войти в длинный слот, который электрически подключён как x4. Для PCIe 3.0 одна линия передаёт 8 GT/s; после кодирования 128b/130b восемь линий дают примерно 63,0 Гбит/с в каждом направлении до остальных накладных расходов PCIe. Четыре линии дают около 31,5 Гбит/с. У двухпортовой карты 2×25G суммарная нагрузка способна приблизиться к ограничению x4 раньше, чем закончатся сетевые возможности обоих портов.
Этот расчёт не доказывает, что любой PCIe 3.0 x8 адаптер выдаст 50 Гбит/с приложению. Остаются DMA, драйвер, CPU, распределение очередей и память. Он помогает обнаружить заведомо слабое место. На установленном сервере полезно проверить фактическую ширину и скорость PCIe, а также отсутствие исправляемых и неисправляемых ошибок шины. Осмотр только надписи x16 на пластиковом разъёме не даёт этой информации.
Уточните высоту планки, длину карты и расположение кабельного выхода. В 1U-системе пригодность платы зависит от штатного райзера и направления воздушного потока. Для мощных адаптеров и горячих трансиверов требуется достаточное охлаждение. Карта, которая устойчиво работает на открытом стенде, может перегреваться под крышкой сервера с забитым фильтром или неподходящим вентиляторным профилем. Упаковочный вариант и наличие нужной планки также лучше проверить в спецификации заказа.
В двухпроцессорных системах выясните, к какому CPU подключён слот. Если один процессор не установлен, некоторые слоты могут оказаться недоступными. NUMA влияет на задержку доступа к памяти и распределение сетевых прерываний. При высокой нагрузке полезно согласовать сетевые очереди и вычисления с расположением адаптера, но начинать стоит с правильной физической установки. Настройка affinity не исправляет карту, которая работает через недостаточное число линий или перегревается.
Выбирать серверную платформу Supermicro удобнее вместе с сетевой картой, райзером и дисковой конфигурацией. Тогда можно проверить весь комплект до оплаты: число свободных линий PCIe, физическое размещение, совместимость прошивок, блоки питания и доступ к обслуживанию. В заявке перечислите точные артикулы. Формулировка «добавить две сетевые по 25G» оставляет слишком много вариантов исполнения и контроллеров.
Как соединить SFP28, QSFP28 и сетевую карту без сюрпризов?
Для короткого соединения внутри стойки обычно рассматривают DAC. Это готовая сборка с оконечными модулями и медным кабелем. Она уменьшает число отдельных компонентов, но требует проверки поддержки с двух сторон. Запишите модель коммутатора, сетевой карты, точный артикул DAC, длину и нужную скорость. Кабель, который работает на одном контроллере, нельзя автоматически считать проверенным для другого сервера лишь из-за одинакового SFP28-разъёма.
AOC представляет собой готовую активную оптическую сборку. Отдельные трансиверы и волокно дают больше свободы при прокладке между стойками и замене частей соединения. Выбор зависит от расстояния, организации кабельных трасс, возможности заменить один модуль и поддержки оборудования. Для оптики совпасть должны скорость, стандарт передатчика, тип волокна, число волокон, разъём и допустимый оптический бюджет. Два модуля с надписью «100G» могут использовать несовместимые схемы передачи.
На 25G и выше отдельно проверяют FEC — исправление ошибок линии. В RouterOS встречаются режимы fec74 и fec91, соответствующие FC-FEC и RS-FEC; применимость зависит от линк-режима и оборудования. Несогласованный FEC может приводить к отсутствию линка или нестабильности. Универсального совета «всегда отключить» здесь нет. Зафиксируйте поддерживаемый режим на обоих концах и проверьте счётчики ошибок после длительного обмена, а не только факт подключения.
Автосогласование тоже зависит от физического режима. Поддерживаемые сочетания скорости, типа линии и breakout перечисляются для конкретных семейств. У CRS5xx QSFP28 может работать как 100G или в поддерживаемом разделении на несколько меньших линий, но это не означает автоматическое получение любого сочетания из кабеля произвольной формы. В настройках новых RouterOS различаются режимы медной и оптической передачи. Старую строку speed из чужой инструкции нельзя без проверки переносить на другую версию и другой трансивер.
Для детальной проверки стандартов пригодится отдельный материал о совместимости SFP, DAC и AOC для MikroTik. В серверном проекте задача шире: проверить нужно ещё поддержку адаптером Supermicro и соответствие схемы всем VLAN и резервным путям. Один совместимый модуль на стороне коммутатора не доказывает работоспособность всей линии. Фотографию маркировки удобно включить в акт приёмки.
У оптического соединения есть ещё эксплуатационная сторона. Патч-корды маркируют с двух концов, защищают от перегиба и не укладывают под силовые кабели так, чтобы их нельзя было заменить. После перестановки кабеля повторяют проверку ошибок. Рост corrected FEC сам по себе нужно оценивать в контексте оборудования, но uncorrectable errors, CRC и потери под нагрузкой требуют разбирательства. Видимый линк 25G означает согласованную скорость, а не гарантированное качество передачи каждого рабочего потока.
Как выглядит проект сети для трёх серверов Supermicro?
Возьмём три узла Proxmox с одной двухпортовой картой 25G на каждом. В базовом варианте по одному порту узла подключается к CRS510, второй пока оставляют для следующего этапа. Встроенный интерфейс сервера используют для отдельной служебной сети Corosync, а выделенный разъём BMC подключают к сети аппаратного управления. Такая схема даёт понятный начальный стенд и позволяет проверить основной тракт без одновременного запуска всех механизмов резервирования.
Этот базовый вариант сохраняет единственный коммутатор в пути данных. Его отказ остановит соответствующий обмен, даже если у каждого сервера два блока питания и достаточно памяти для всех ВМ. Это ограничение включают в проект прямо. Для системы с требованием пережить отказ коммутатора добавляют второй CRS, вторые серверные подключения и согласованный механизм резервирования. Само присутствие второй коробки в стойке не делает схему отказоустойчивой.
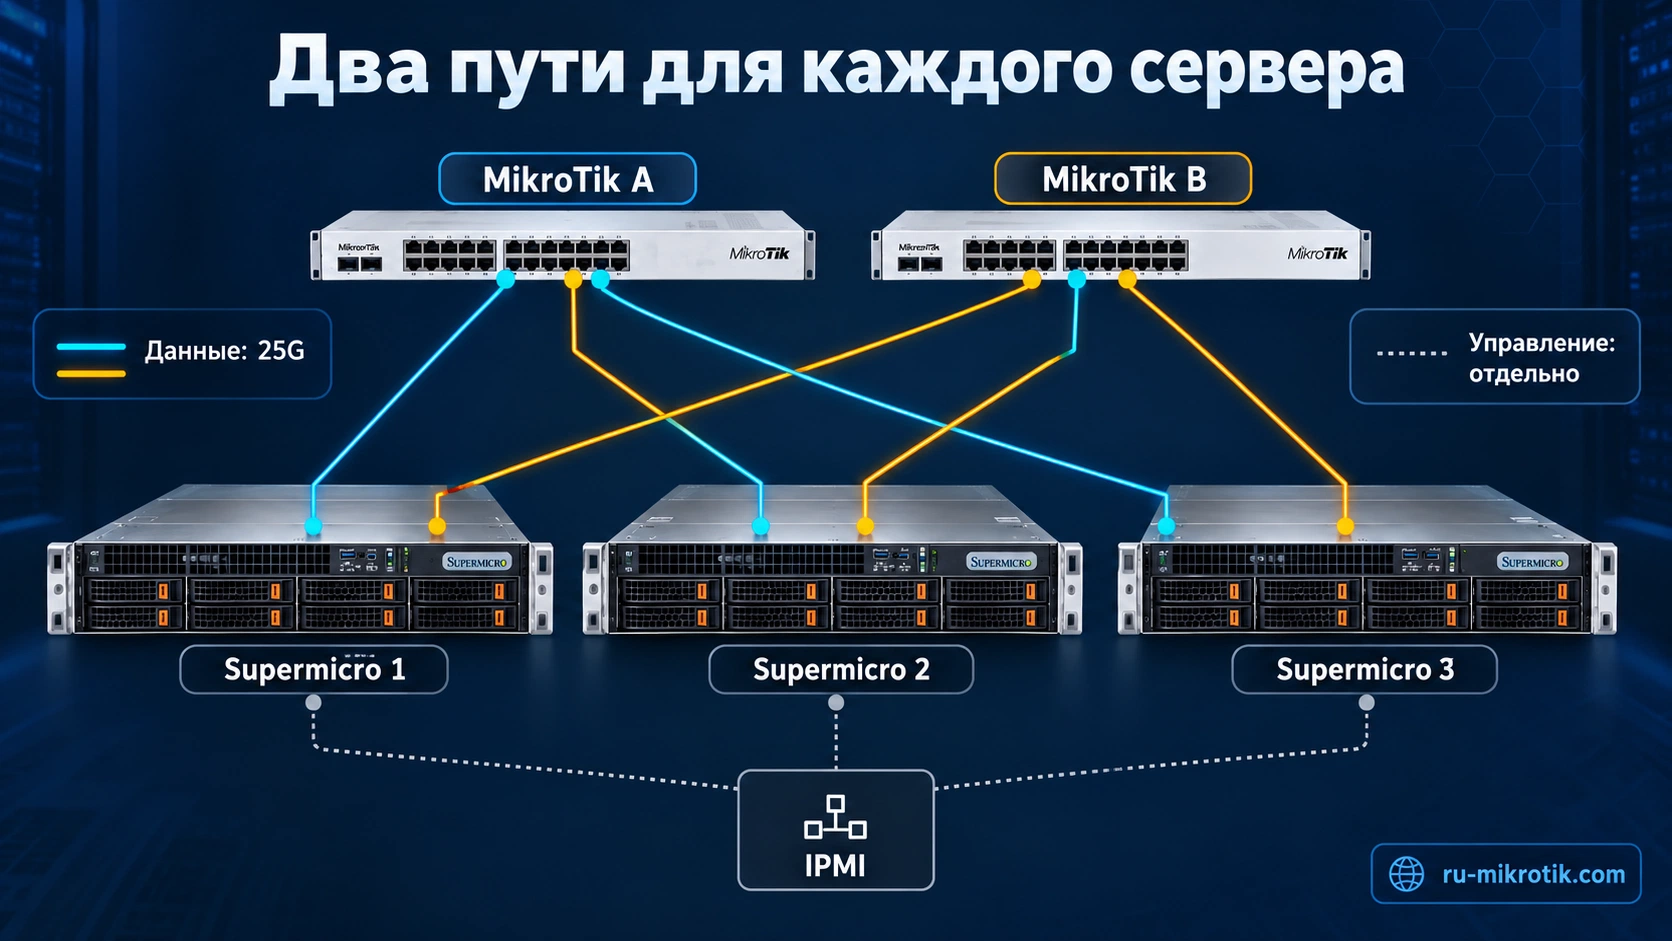
В расширенном варианте каждый хост имеет путь к MikroTik A и MikroTik B. Дальше выбирают active-backup, MLAG с LACP или отдельные маршрутизируемые пути для подходящего приложения. Решение зависит от хранилища, требований к единому L2-сегменту и поддерживаемых функций. Межкоммутаторные связи, отказ peer-link, отказ uplink и сохранение доступа к шлюзу проектируют до включения второго канала. Для трёх серверов необязательно строить большую фабрику ЦОД, но исключить эти вопросы из схемы нельзя.
Общий бюджет соединений считают по разъёмам на каждом конце. Три сервера, подключённые к двум коммутаторам, требуют шесть серверных линий. Это шесть DAC-сборок либо двенадцать трансиверов и шесть оптических трасс. Межкоммутаторные подключения и uplink в эти шесть не входят. Если понадобится отдельная пара линий хранения на каждом хосте, число серверных подключений удвоится. Такой подсчёт быстро показывает, подходит ли выбранное число портов.
Сразу предусмотрите место для временного подключения администратора и тестового сервера. Во время миграции оборудования свободный порт часто нужнее очередного теоретического запаса скорости. Полезно оставить возможность подключить старое хранилище для переноса данных и проверить резервную копию на отдельном хосте. Если все порты заняты в первый день, плановое обслуживание будет зависеть от отключения работающих систем. Это скрытая стоимость слишком тесного первоначального проекта.
Как разделить IPMI, управление Proxmox и Corosync?
Для IPMI/BMC выделяют отдельную подсеть и контролируемый доступ администратора. Она нужна, когда основная ОС недоступна или сетевые настройки хоста испорчены. Адреса BMC не следует выдавать из пользовательской сети ВМ. Удобно заранее составить соответствие «серийный номер — имя хоста — адрес BMC — порт коммутатора». При аварии это позволяет открыть нужный сервер без угадывания по одинаковым передним панелям.
Панель Proxmox имеет другой адрес и обычно доступна через TCP 8006. SSH относится к ОС гипервизора. Разрешённые источники доступа задают на подходящем firewall, не открывая управление всем VLAN с ВМ. Если администратор приходит через VPN или выделенный рабочий сегмент, эти пути тоже проверяют. Рабочий доступ к BMC через тот же единственный маршрутизатор, который вы сейчас перенастраиваете, может оказаться недостаточно независимым для восстановления.
Corosync связывает узлы кластера; его сеть не стоит превращать в универсальную сеть копирования. Для небольшой установки стабильный отдельный 1G-путь часто полезнее общего 25G-пути с большой очередью. Здесь важна предсказуемая задержка под нагрузкой. Проверяют доступность всех узлов друг для друга и отсутствие потерь во время миграции, резервного копирования и восстановления хранилища. Средний ping на пустой сети показывает лишь небольшой фрагмент поведения.
Дополнительный Corosync link должен проходить через другую физическую сеть. Два VLAN на одном кабеле не переживут его обрыв. Два порта одной карты могут одновременно исчезнуть при отказе самой карты. Два коммутатора, подключённые к одному отключённому PDU, также не обеспечат независимость питания. Поэтому в схеме рисуют физические зависимости: сетевые карты, коммутаторы, линии питания и маршруты управления. Логическая схема без этих зависимостей создаёт ложное чувство резерва.
Для кластера из трёх голосующих узлов обычное большинство составляет два голоса. При потере связи одного узла оставшиеся два могут сохранить кворум; поведение ВМ и хранения определяется дополнительными настройками. Потеря кворума, отказ сетевого пути и отказ диска — разные события. HA не означает продолжение работы той же ВМ без единой паузы. Проект должен объяснять, когда выполняется миграция, когда перезапуск, а когда требуется вмешательство администратора.
Какую схему VLAN и IP-адресов использовать в Proxmox?
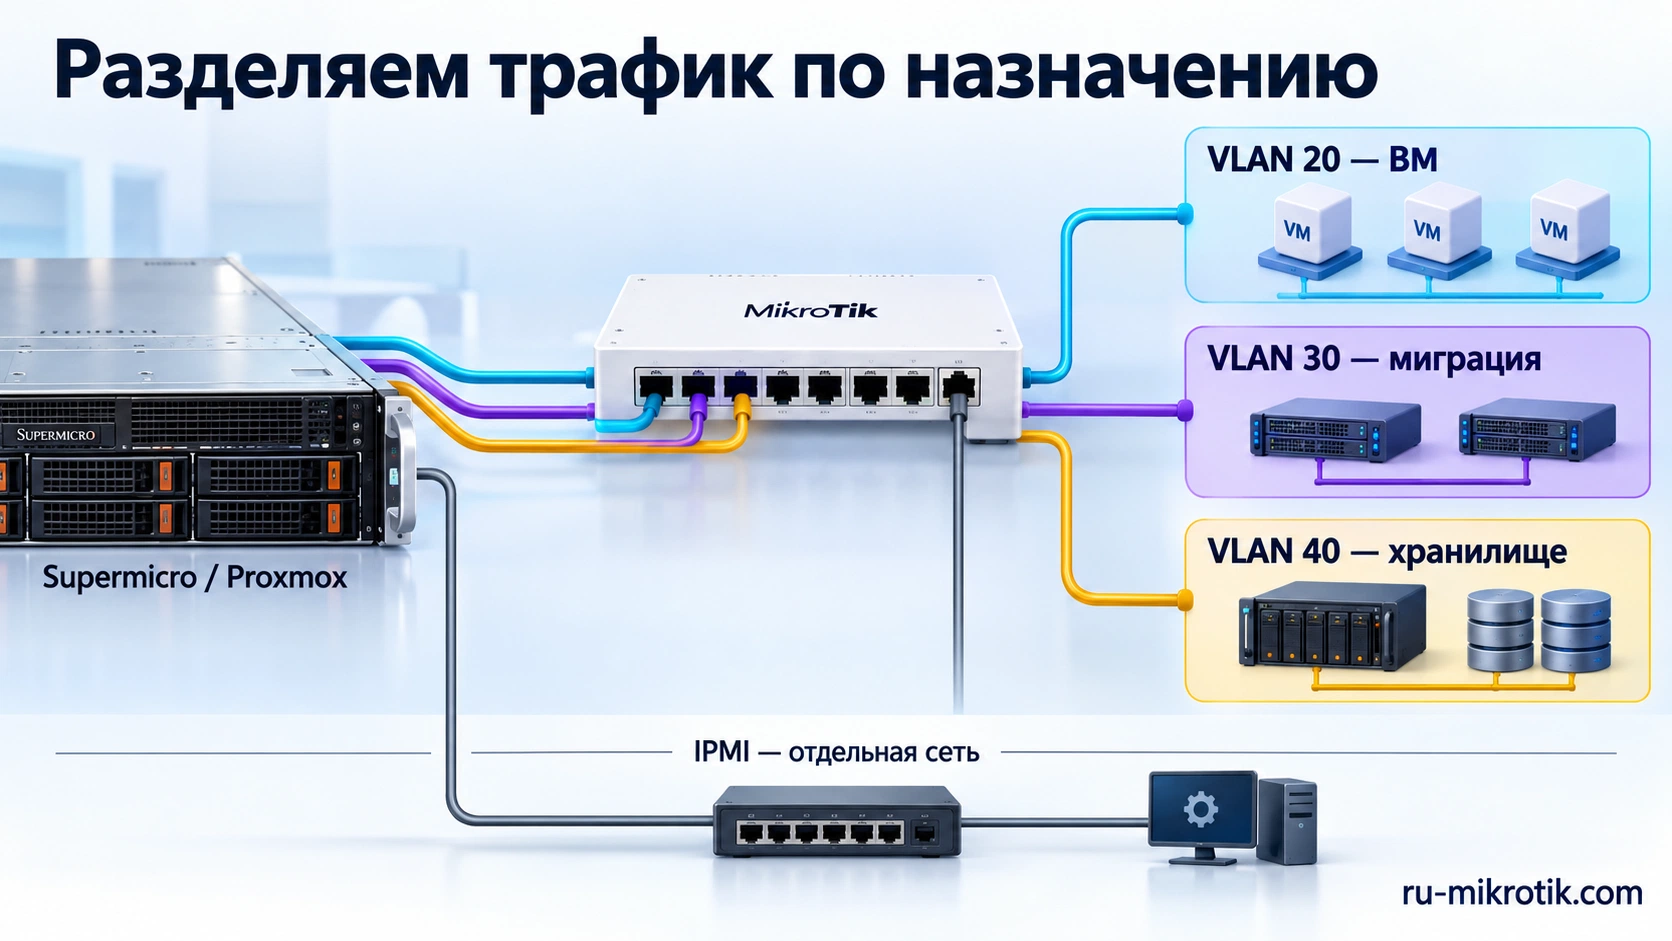
Ниже приведён условный адресный план. Его нельзя механически смешивать с уже действующей сетью: сначала исключите совпадения с офисом, VPN и удалёнными площадками. Для каждого сегмента запишите назначение, VLAN ID, подсеть, наличие шлюза и список разрешённых направлений. Адреса управления, хранения и миграции назначаются хостам по одной системе, чтобы номер узла был узнаваем. Например, окончания .11, .12 и .13 относятся к первым трём серверам.
| VLAN / сегмент | Пример подсети | Назначение | Шлюз по умолчанию на хосте |
|---|---|---|---|
| 10 | 10.60.10.0/24 | Управление Proxmox | Единственный default gateway: 10.60.10.1 |
| 20 | 10.60.20.0/24 | Одна из сетей ВМ | Шлюз настраивается внутри соответствующих ВМ |
| 30 | 10.60.30.0/24 | Миграция | В примере отсутствует |
| 40 | 10.60.40.0/24 | Хранилище | В примере отсутствует |
| 50 | 10.60.50.0/24 | Резервное копирование | В примере отсутствует |
| 60, отдельный физический путь | 10.60.60.0/24 | Corosync | В примере отсутствует |
| 90, сеть аппаратного управления | 10.60.90.0/24 | IPMI/BMC | Настраивается на BMC по схеме доступа администратора |
VLAN 10–50 в примере могут передаваться общим trunk через быстрый серверный порт. Сегмент Corosync идёт через отдельный интерфейс и другой физический путь. Подсеть BMC относится к контроллеру управления, а не к Linux bridge. Это разделение позволяет диагностировать неисправности по слоям: если панель Proxmox пропала после правки trunk, BMC остаётся доступным независимо от конфигурации vmbr.
На trunk разрешайте конкретный перечень VLAN. Диапазон 2–4094 удобен на стенде, но в рабочей сети открывает лишние логические сегменты. Если сервер должен передавать только 10, 20, 30, 40 и 50, согласуйте именно эти номера на коммутаторе и на хосте. Добавление новой сети оформляют изменением в обоих местах. Порядок действий должен сохранять текущий доступ администратора до завершения проверки.
VLAN разделяет широковещательные домены, но не является полной политикой безопасности. Если между VLAN работает маршрутизатор без ограничений, ВМ из пользовательского сегмента могут обратиться к управлению через маршрутизацию. Нужны явные разрешения и запреты по направлениям. Для хранилища отдельно проверяют, какие узлы имеют право подключаться к сервису, а не просто находятся в нужной подсети. Наличие номера 40 в таблице не заменяет аутентификацию и настройки самого хранилища.
Обычно у хоста оставляют один маршрут по умолчанию. Дополнительные локальные подсети доступны через собственные интерфейсы, а при необходимости удалённых сегментов добавляют осмысленные маршруты. Несколько случайно назначенных default gateway могут дать асимметричный обмен: запрос приходит одним путём, ответ уходит другим. Веб-панель при этом иногда открывается из одной сети и не открывается из другой. Это повод проверить таблицу маршрутов, а не менять все VLAN сразу.
Как настроить trunk MikroTik для серверов Proxmox?
Для первого запуска достаточно трёх серверных trunk-портов и одного trunk к существующему шлюзу. В примере они заранее переименованы в PVE1, PVE2, PVE3 и UPSTREAM. Реальные имена физических интерфейсов определяют через список портов конкретной модели. Приведённый фрагмент рассчитан на отдельный тестовый коммутатор с RouterOS 7; он не учитывает уже существующие мосты, адреса и правила работающей сети.
Управление коммутатором в этом примере остаётся через отдельный, заранее проверенный интерфейс. Встроенный CPU-порт моста не включён в VLAN 10–50, поскольку на самом CRS не создаются IP-интерфейсы этих VLAN и не выполняется межсегментная маршрутизация. Так основной серверный обмен остаётся L2-задачей. Если вы хотите управлять самим CRS через VLAN 10, CPU-порт и VLAN-интерфейс добавляются осознанно, вместе с ограничениями доступа к сервисам.
/interface bridge
add name=br-pve vlan-filtering=no protocol-mode=rstp

/interface bridge port
add bridge=br-pve interface=PVE1 ingress-filtering=yes frame-types=admit-only-vlan-tagged
add bridge=br-pve interface=PVE2 ingress-filtering=yes frame-types=admit-only-vlan-tagged
add bridge=br-pve interface=PVE3 ingress-filtering=yes frame-types=admit-only-vlan-tagged
add bridge=br-pve interface=UPSTREAM ingress-filtering=yes frame-types=admit-only-vlan-tagged

/interface bridge vlan
add bridge=br-pve tagged=PVE1,PVE2,PVE3,UPSTREAM vlan-ids=10,20
add bridge=br-pve tagged=PVE1,PVE2,PVE3 vlan-ids=30,40,50

/interface bridge
set [find name=br-pve] vlan-filtering=yes
Здесь VLAN 30, 40 и 50 остаются между тремя хостами и не уходят в UPSTREAM. Такая запись подходит, пока сервер хранения и резервного копирования находится на одном из этих узлов либо подключается отдельно с явным добавлением порта. Если внешний backup-сервер подключён через UPSTREAM, VLAN 50 нужно разрешить на этом направлении. Таблица должна описывать реальную топологию. Открывать все VLAN на всякий случай проще, но тогда схема перестаёт объяснять границы обмена.
Сначала создают мост и записи VLAN, затем включают filtering. Удалённое изменение без консоли или независимого управления способно отрезать администратора. Для правок действующего CRS применяют подготовленный план и предусмотренный способ отката, проверяют текущее состояние и не вставляют команды создания дублирующего моста. Safe Mode полезен для ряда изменений RouterOS, но наличие аппаратного доступа всё равно стоит проверить до начала работ.
После применения смотрят таблицу VLAN, состав bridge ports и фактическое аппаратное ускорение. Флаг настройки hw=yes выражает намерение использовать ускорение, а рабочее состояние нужно проверять отдельно. Нагрузка на CPU и результаты передачи помогают обнаружить программный обход, но низкий CPU сам по себе не подтверждает корректную изоляцию. Отдельно протестируйте, что нетегированный трафик не проходит через серверный trunk и что запрещённый VLAN действительно отбрасывается.
Проверка отрицательных сценариев часто обнаруживает ошибку раньше нагрузочного теста. Подключите тестовую ВМ к разрешённому VLAN 20 и убедитесь в её связи со шлюзом. Затем проверьте неразрешённый VLAN на том же пути. Он не должен неожиданно получить доступ к внешней сети. Не используйте для такого эксперимента действующую ВМ с критичным приложением. Одноразовая тестовая машина позволяет проверить изоляцию без изменения производственного сервиса.
Как настроить сеть Proxmox через /etc/network/interfaces?
На Proxmox можно использовать веб-интерфейс узла или файл /etc/network/interfaces. Сначала определите реальные имена сетевых карт и сохраните текущую конфигурацию. Имена enp65s0f0 и eno1 ниже условные; они должны соответствовать именно вашим физическим портам. Проверить это удобно кратким отключением тестового кабеля и наблюдением carrier в согласованное окно, а также по MAC-адресам и маркировке портов.
В базовой конфигурации быстрый порт включён в VLAN-aware Linux bridge vmbr0. На физическом интерфейсе IP-адреса нет. Адрес управления назначается vmbr0.10, а миграции — vmbr0.30. Сеть 40 и 50 проходят через мост для последующей настройки хранения и backup. Включать на каждом хосте все возможные IP-интерфейсы заранее не требуется: каждый адрес должен иметь понятного получателя и назначение.
auto lo
iface lo inet loopback

iface enp65s0f0 inet manual

auto vmbr0
iface vmbr0 inet manual
    bridge-ports enp65s0f0
    bridge-stp off
    bridge-fd 0
    bridge-vlan-aware yes
    bridge-vids 10 20 30 40 50

auto vmbr0.10
iface vmbr0.10 inet static
    address 10.60.10.11/24
    gateway 10.60.10.1

auto vmbr0.30
iface vmbr0.30 inet static
    address 10.60.30.11/24

auto eno1
iface eno1 inet static
    address 10.60.60.11/24

source /etc/network/interfaces.d/*
Для второго и третьего узла окончания адресов меняются на .12 и .13. Интерфейс eno1 подключён к отдельной служебной сети без default gateway. Здесь bridge-stp off допустим для показанной схемы с одним физическим портом в мосту. Если топология меняется и появляется возможность L2-петли, её предотвращение нужно проектировать заново. Переносить этот параметр в произвольную многопортовую схему без анализа нельзя.
Сохранение файла не доказывает работоспособность конфигурации. До применения откройте аппаратную консоль, проверьте доступ к BMC и сохраните исходные адреса. При штатном использовании ifupdown2 изменения можно применять через механизмы Proxmox, но ошибка в имени интерфейса, VLAN или шлюзе всё равно способна прервать сессию. Не выполняйте массовую перенастройку всех узлов одновременно. Сначала один тестовый или освобождённый хост, затем проверка доступности и только потом остальные.
На каждом узле сравните имя vmbr0 и назначение VLAN. При миграции ВМ bridge с тем же именем должен вести в ту же логическую сеть. Одинаковое название vmbr0 при разных trunk-настройках создаёт особенно неприятную ошибку: миграция формально завершается, а приложение теряет связь. Сеть до и после переноса проверяется одним и тем же тестом, включая доступ к шлюзу, DNS и нужному приложению.
Файл interfaces описывает сетевые интерфейсы, но не все параметры кластера. Настройка migration network, Corosync links, storage и firewall выполняется в соответствующих разделах Proxmox. Наличие адреса vmbr0.30 само по себе не заставляет миграцию использовать эту сеть. После выбора нужной подсети запустите тестовый перенос и посмотрите счётчики именно предполагаемого интерфейса. Так обнаруживается маршрут, который остался на старом управленческом пути.
Почему виртуальная машина не получает сеть после настройки VLAN?
Для простой ВМ с одним VLAN назначают bridge vmbr0 и VLAN tag 20 в сетевом адаптере виртуальной машины. Внутри гостевой ОС в этом варианте настраивается обычный интерфейс без дополнительного тега 20. Proxmox выполняет нужную обработку на границе ВМ и VLAN-aware моста. Если тот же тег одновременно добавить внутри гостя, можно получить другую схему, чем планировалось. Конфигурация для VLAN trunk внутри гостя требует отдельного осознанного решения.
Проверяйте последовательно: есть ли линк у физической карты, входит ли нужный интерфейс в vmbr0, разрешён ли VLAN на Linux bridge, указан ли он на виртуальном адаптере, разрешён ли на порту MikroTik и существует ли шлюз в этой сети. После этого проверяют DHCP либо статический адрес, маску, DNS и firewall. Пять одновременных изменений затрудняют поиск: рабочий результат появится, но причина останется неизвестной.
Если ВМ видит соседнюю ВМ, но не интернет, локальная коммутация может уже работать. Тогда нужно проверить шлюз, маршрутизацию, правила firewall и при необходимости NAT на выбранном маршрутизаторе. NAT не является обязательным свойством сети Proxmox и не должен включаться на каждом хосте автоматически. При нормальной маршрутизируемой схеме гипервизор передаёт кадры, а выход в другие сети обеспечивает назначенный шлюз. Так сохраняется понятное место для политики доступа.
Если связь есть только между ВМ на одном хосте, подозрение падает на физический trunk, таблицу VLAN, MTU или порт коммутатора. Локальный трафик между гостями может не выходить через сетевую карту вовсе. Успешное копирование между двумя ВМ на одном сервере поэтому не доказывает скорость 25G-подключения. Для проверки физического тракта разместите участников на разных узлах и контролируйте счётчики нужных портов MikroTik.
Разделяйте диагностику сети гостя и сети хоста. Адрес управления Proxmox может работать в VLAN 10, тогда как ВМ ошибочно отправляется в VLAN 200. Обратная ситуация тоже возможна: пользовательское приложение доступно, а администратор потерял панель узла. У этих случаев разные причины и способы восстановления. Таблица с привязкой каждой ВМ к bridge, tag, подсети и шлюзу значительно сокращает время поиска, особенно после переноса на другой сервер.
Bond, LACP или MLAG: как резервировать серверные подключения?
Bond объединяет несколько физических интерфейсов Linux в один логический. Его поведение определяется режимом. В active-backup в каждый момент активен один участник; второй используется при обнаруженном отказе основного. В 802.3ad используется согласованная агрегация LACP, которая распределяет потоки по доступным участникам. Выбор режима должен совпадать с возможностями и настройками противоположной стороны, иначе часть соединений может выглядеть рабочей только в отдельных направлениях.
Два порта по 25G в active-backup сохраняют рабочую скорость одного 25G-порта. В LACP суммарный обмен нескольких подходящим образом распределённых потоков может использовать обе линии, но обычный одиночный TCP-поток чаще остаётся на одном участнике. Поэтому обещать каждой ВМ 50 Гбит/с только по наличию bond неправильно. Результат зависит от хеширования, числа потоков, получателей и ограничений самого сервера.
Два независимых коммутатора не превращаются в один LACP-партнёр автоматически. Для распределённой агрегации нужен поддерживаемый механизм, например MLAG, с согласованной настройкой пары. У него есть peer-link, синхронизация состояния и собственные аварийные сценарии. Если просто подключить участников одного LACP bond к двум никак не согласованным CRS, корректного общего агрегатора не получится. Часть клиентов может терять связь, хотя все кабели физически исправны.
Active-backup может применяться с двумя коммутаторами, если оба пути приводят в требуемую сеть и переключение проверено для всей топологии. Контроль carrier обнаруживает локальное пропадание линка, но не каждый отказ дальше по пути. Например, сервер видит свой порт активным, а uplink данного коммутатора уже недоступен. Для таких случаев анализируют дополнительные механизмы контроля и саму архитектуру. Резервный порт должен сохранять доступ к нужному шлюзу и данным, а не просто показывать состояние UP.
| Вариант | Что даёт | Что не следует считать автоматическим |
|---|---|---|
| Один порт 25G | Простой понятный тракт | Резерв при отказе порта или коммутатора |
| Active-backup 2×25G | Переключение между двумя участниками | 50G одному потоку, обнаружение любого удалённого отказа |
| LACP 2×25G на один CRS | Агрегация нескольких потоков и резерв линии | Защита от отказа самого CRS |
| LACP через MLAG-пару | Подключение к согласованной паре коммутаторов | Безошибочное поведение без проверки peer-link и конфигурации |
| Две независимые IP-сети | Раздельные пути для поддерживающего их ПО | Общий L2 bond и автоматический multipath для любого сервиса |
Для первого теста active-backup можно подготовить два физических интерфейса enp65s0f0 и enp65s0f1, создать bond0 и затем заменить bridge-ports у vmbr0 на bond0. Адреса VLAN-интерфейсов в такой схеме остаются на прежних логических устройствах. Ниже показана только добавляемая часть: её нужно согласовать с существующим файлом, убрав прежнее прямое включение физического порта в мост. Одновременно включать тот же порт и отдельно, и как участника bond не следует.
iface enp65s0f0 inet manual
iface enp65s0f1 inet manual

auto bond0
iface bond0 inet manual
    bond-slaves enp65s0f0 enp65s0f1
    bond-mode active-backup
    bond-miimon 100

# В существующем vmbr0 вместо физического порта:
# bridge-ports bond0
Параметр miimon в этом примере проверяет состояние линии с интервалом 100 миллисекунд. Это не обещание восстановить приложение за 100 миллисекунд. Обнаружение отказа, выбор участника, обновление MAC-таблиц, ARP и повторная передача приложением занимают своё время. Приёмочный тест фиксирует именно пользовательский перерыв и ошибки приложения. Счётчик переключений bond полезен, но не заменяет этот результат.
Для MLAG перед работами сопоставьте установленную версию RouterOS с синтаксисом инструкции. Начиная с ветки 7.22 настройка MLAG перенесена в параметры bridge; старые примеры используют другой раздел меню. Дополнительно учитывают ограничения сочетания с L3 hardware offloading. Здесь полезнее согласованный проект и проверка конкретного режима, чем ещё одна универсальная копируемая команда. Версию, модели обоих CRS и схему peer-link внесите в документацию сети.
Как связаны сеть MikroTik, Ceph и хранилище виртуальных машин?
Сначала определите, где находятся диски ВМ: локально на каждом хосте, на общем NAS/SAN или в распределённом хранилище. У локальных дисков обычный ввод-вывод приложения может вообще не выходить в сеть. В случае сетевого хранилища значительная часть операций проходит через адаптер и коммутатор. При распределённом хранении добавляются обмен между узлами, репликация и восстановление. Поэтому одинаковые виртуальные машины создают разные требования к сети при разных способах хранения.
Для Ceph в Proxmox исходной точкой служит выделенная сеть не менее 10 Гбит/с, а быстрые SSD и NVMe часто требуют дальнейшего расчёта. Одного числа дисков недостаточно: нагрузка зависит от чтения и записи, размера операций, числа клиентов, размещения копий и состояния кластера. Полоса нужна и для полезных запросов, и для внутренних перемещений данных. Особенно тяжёлый режим возникает при восстановлении после отказа, когда обычные приложения продолжают работать.
Упрощённая модель записи с тремя копиями помогает увидеть масштаб: клиент передаёт данные основному получателю, после чего появляются передачи для других копий. Из клиентской записи 1 ГБ/с нельзя автоматически сделать вывод «нужна сеть ровно 8 Гбит/с на всю систему». Точный трафик зависит от размещения и пути клиента. Для предварительного бюджета отдельно оценивают клиентский обмен, межузловую репликацию и восстановление; затем проверяют их вместе на стенде.
Public network и cluster network в Ceph имеют разные роли. Их разделение может быть полезным, но две подсети на одной перегруженной карте не увеличивают физическую полосу. Если обе проходят одним 25G-портом, этот предел остаётся общим. Для действительно независимых путей понадобятся отдельные интерфейсы и соответствующая коммутационная схема. Проектирование самого Ceph, числа копий и доменов отказа относится к хранилищу; сеть должна обеспечить выбранному проекту необходимые условия.
Особое внимание уделите восстановлению. Допустим, нужно передать 2 ТБ данных за один час. Только полезный поток составит примерно 4,44 Гбит/с без накладных расходов. Если выделить на эту задачу 5 Гбит/с, теоретический предел выглядит достаточным, но запас мал и ещё не учтены конкурирующие операции. При двух часах требование снижается примерно до 2,22 Гбит/с. Такие расчёты помогают обсуждать окно восстановления в измеримых величинах вместо абстрактного «нужно побыстрее».
Для iSCSI и NFS также проверяют путь приложения и поддерживаемый способ резервирования. Две сетевые карты не создают multipath автоматически. У iSCSI требуется согласовать инициатор, целевые интерфейсы, отдельные пути и настройки multipath. Для NFS варианты зависят от версии протокола, сервера и клиента. Bond может решать задачу доступности интерфейса, но его возможности нельзя подменять возможностями конкретного протокола хранения.
Сеть не исправляет неподходящий дисковый тракт. Ограничением могут стать SATA SSD, контроллер, backplane, PCIe-подключение NVMe и задержки синхронной записи. Сначала измерьте локальную работу хранилища безопасным тестом на выделенных данных, затем сетевой обмен и только после этого — приложение через выбранный протокол. Такой порядок позволяет понять, за что именно предлагается доплатить: за сетевую скорость, диски или другой способ размещения данных.
Сколько времени займёт миграция ВМ через 10G или 25G?
У миграции есть несколько составляющих: передача памяти и состояния ВМ, возможное копирование дисков, подготовка на принимающем узле и короткая заключительная остановка. Если диски уже доступны через общее хранилище, их полный перенос может не требоваться. При локальном размещении и выбранном переносе storage трафик будет другим. Поэтому время миграции нельзя определять только объёмом виртуального диска или только выделенной памятью.
Возьмём ВМ с 128 ГиБ памяти. Объём составляет около 137,44 десятичного ГБ. При измеренной полезной скорости передачи 2 ГБ/с одна полная передача такого объёма потребовала бы примерно 68,7 секунды. Это расчёт для условной скорости, а не результат теста Supermicro. На работающей ВМ страницы памяти продолжают меняться, некоторые передаются повторно. Чем интенсивнее изменения, тем труднее завершить перенос в короткое окно.
Если приложение изменяет память быстрее, чем её удаётся эффективно передавать, высокая загрузка канала сама по себе не гарантирует успешную быструю live migration. Может потребоваться другой режим, ограничение активности или согласованное окно. Дополнительно проверяют совместимость CPU, доступность устройств и особенности passthrough. Наличие быстрого 100G-соединения не делает любую виртуальную машину мигрируемой. Проброс физического устройства требует отдельной проверки поддерживаемого сценария.
Выберите отдельную migration network в настройках Proxmox и убедитесь, что используется нужная подсеть. Во время теста смотрят нагрузку на физическом порту, VLAN-интерфейсе и принимающей стороне. Если перенос продолжает идти через гигабитное управление, покупка быстрого коммутатора не даст ожидаемого эффекта. Также проверьте ограничения скорости миграции: они могли остаться от прежней сети и удерживать поток значительно ниже возможностей нового линка.
Время обслуживания узла рассчитывают для всех ВМ, которые нужно с него убрать. Пять машин не обязательно мигрируют за время одной: ограничены исходящий интерфейс, принимающие хосты, хранилище и допустимая параллельность. Иногда последовательный перенос даёт предсказуемое окно и меньше влияет на пользователей. Приёмочный сценарий должен соответствовать рабочему порядку: какие ВМ переносятся первыми, сколько одновременно, куда попадают диски и как проверяется приложение после каждого шага.
Почему резервное копирование тормозит сеть и как задать ему окно?
Объём всех дисков ВМ и объём фактически передаваемой резервной копии различаются. На результат влияют изменённые блоки, дедупликация, сжатие, выбранный режим и состояние репозитория. Для сетевого бюджета полезно брать наблюдаемый объём ночной передачи и отдельно оценивать первый полный проход. Первый backup после внедрения может быть гораздо тяжелее обычного дня и совпасть с другими задачами подготовки инфраструктуры.
Условные 6 ТБ нужно передать за восемь часов. Минимальная полезная средняя скорость составляет около 208,3 МБ/с, то есть 1,67 Гбит/с. На гигабитной сети такое окно не укладывается даже без накладных расходов. На 10G запас может быть достаточным, если диски и программа обеспечивают нужный поток. Но если тот же канал занят хранилищем и миграцией, сравнивать 1,67 Гбит/с с номинальными 10G недостаточно: нужен бюджет одновременного обмена.
Не давайте резервному копированию без ограничений занимать любой свободный ресурс, если от этого растёт задержка рабочих приложений. Выберите подходящее расписание, число параллельных задач и ограничение скорости в самом ПО. Перенос backup в отдельный VLAN полезен для управления доступом, но сам по себе не гарантирует полосу другим потокам. Отдельная карта или путь даёт более явное физическое разделение, хотя увеличивает число портов и кабелей.
Проектируйте не только создание копии, но и восстановление. Если после аварии нужно вернуть 1 ТБ за 30 минут, полезная средняя скорость должна быть не ниже 555,6 МБ/с, примерно 4,44 Гбит/с. К этому добавляются чтение из репозитория, возможная распаковка, запись на целевое хранилище и запуск приложения. Успешный ночной backup на 2 Гбит/с не доказывает выполнение такого требования восстановления.
Отдельный сервер резервного копирования полезно подключать так, чтобы основной отказ не лишал сразу и работающих ВМ, и пути к их копиям. Это не сводится к дополнительному сетевому кабелю: учитываются питание, размещение, доступы и сами носители. Приёмку заканчивают восстановлением тестовой машины и проверкой её данных. Отчёт «задача завершена» без пробного восстановления оставляет слишком большой пробел в понимании готовности инфраструктуры.
Нужно ли включать MTU 9000 на MikroTik и Proxmox?
Jumbo frames уменьшают число пакетов при передаче больших объёмов, но требуют согласованного размера на всём пути. В тракт входят виртуальный адаптер, гостевая ОС, Linux bridge, bond при его наличии, физическая карта, порты коммутатора и получатель. Один участок с меньшим допустимым размером способен дать потери, фрагментацию в подходящих условиях или зависание отдельных операций. Нормальный короткий ping такую проблему может не показать.
Начинать приёмку проще с MTU 1500. Когда базовая связность и скорость подтверждены, изменение MTU проводят отдельным шагом на выбранном сегменте. Для хранения или миграции можно проверить 9000, если все участники поддерживают нужный размер. Сеть пользователей и интернет при этом не обязаны получать тот же параметр. Нужно понимать различия между IP MTU, L2 MTU и полным размером Ethernet-кадра с тегами.
Для IPv4 в Linux команда ping с запретом фрагментации и полезной нагрузкой 1472 байта проверяет пакет IP размером 1500 байт: добавляются 20 байт IPv4 и 8 байт ICMP. Для IP MTU 9000 аналогичная полезная нагрузка составляет 8972 байта. Эти значения не переносятся без изменения на IPv6. Проверяйте оба направления между хостами и отдельно путь из ВМ, поскольку на одном из виртуальных участков может остаться прежний размер.
# Примеры для Linux и IPv4; получатель — тестовый соседний узел
ping -M do -s 1472 -c 10 10.60.30.12

# Только после согласованной настройки IP MTU 9000 по всему пути
ping -M do -s 8972 -c 10 10.60.30.12
Сравнивайте результат приложения до и после изменения. Jumbo frames не гарантируют одинаковый выигрыш на всех нагрузках, а маленькие транзакции могут зависеть совсем от других факторов. Если прирост несущественен, сложность сопровождения тоже стоит учитывать. В документации сети должны остаться точные значения на каждом сегменте. Через полгода новый администратор не должен узнавать о нестандартном MTU только по зависшему переносу большого файла.
Как проверить скорость 25G и не измерить что-то другое?
Сначала измеряют обмен между двумя физическими хостами без дисковой операции. Для этого подходит iperf3, который создаёт тестовый сетевой поток. На одном узле запускают сервер, на другом клиент. Выберите адрес нужной подсети, например миграции, чтобы трафик точно шёл через проверяемый тракт. Результат между loopback-адресами или двумя ВМ одного хоста ничего не говорит о скорости внешней карты.
# Узел PVE2, адрес в VLAN миграции
iperf3 -s -B 10.60.30.12

# Узел PVE1: один поток, затем несколько потоков и обратное направление
iperf3 -c 10.60.30.12 -B 10.60.30.11 -t 60
iperf3 -c 10.60.30.12 -B 10.60.30.11 -t 60 -P 4
iperf3 -c 10.60.30.12 -B 10.60.30.11 -t 60 -P 4 -R
Четыре параллельных потока помогают увидеть, отличается ли ограничение одного потока от суммарной возможности тракта. Это не означает, что ваше приложение автоматически получит такой же результат. Одновременно наблюдают загрузку CPU, очередей, сетевые ошибки и retransmits. Версию iperf3 записывают: его реализация и использование потоков менялись. При высоких скоростях ограничение тестового инструмента или одного ядра нельзя принимать за предел коммутатора.
Затем повторяют тест из ВМ на разных физических хостах. Сравнение показывает влияние виртуального адаптера, количества vCPU, очередей и настроек гостевой ОС. Ещё один этап — проверка приложения и хранилища. Если iperf проходит быстро, а файл копируется медленно, подозрение смещается к дискам, протоколу, CPU, антивирусной проверке или самому приложению. Нельзя одним числом заменить все эти измерения.
Нагрузочный тест дополняют наблюдением задержки. Короткие запросы отправляют одновременно с длительным потоком и смотрят, как растёт время ответа. Пустая сеть с прекрасным ping может давать длинные очереди при насыщении. Для рабочего проекта интересны не только средние значения, но и выбросы, потери, длительность пауз. В протоколе указывают направление, число потоков, продолжительность, MTU и состояние остальных задач, чтобы результат можно было воспроизвести.
Что ограничивает скорость внутри виртуальной машины?
Физическая карта может передавать данные быстро, пока виртуальная машина упирается в одно занятое ядро. У сетевого обмена есть обработка прерываний, очереди, копирование и работа сетевого стека гостя. Для KVM обычно используют подходящий виртуальный адаптер VirtIO с установленным драйвером. В Windows отдельно проверяют версию гостевого драйвера, в Linux — обнаруженный тип устройства и его параметры. Замена коммутатора не устраняет ограничение неправильного виртуального адаптера.
Количество vCPU само по себе не гарантирует распределение одного потока на все ядра. Multiqueue помогает определённым профилям нагрузки, но число очередей выбирают с учётом ресурсов гостя и хоста. Слишком много очередей для небольшой ВМ увеличивает накладные расходы, а слишком мало может ограничивать параллельный обмен. Не переносите параметр с большой вычислительной ВМ на каждый служебный сервер. Сначала сравните один поток, несколько потоков и фактическую загрузку процессоров.
На стороне физической карты похожую роль играет распределение приёма по очередям и CPU. При этом один занятый обработчик способен ограничить обмен, хотя общая загрузка многопроцессорного Supermicro выглядит низкой. Средние 5% на большом сервере могут скрывать полностью занятое отдельное ядро. Поэтому наблюдают загрузку по ядрам и типу работы, а не только общий график. На двухсокетной системе дополнительно проверяют NUMA-размещение адаптера, памяти и выполняющейся нагрузки.
Размер пакета тоже меняет характер задачи. Для Ethernet с минимальным кадром 64 байта и дополнительными 20 байтами на преамбулу и межкадровый интервал номинальные 10G соответствуют примерно 14,88 миллиона кадров в секунду. Для 25G получается около 37,20 миллиона. Это расчёт физического темпа, не результат приложения. Передавать те же гигабиты крупными кадрами означает обрабатывать значительно меньше пакетов, поэтому две нагрузки с одинаковым битрейтом по-разному занимают CPU.
Из этого следует полезное правило тестирования: большой последовательный поток и поток коротких запросов проверяются отдельно. Файловому серверу может хватать высокой пропускной способности, тогда как сервису с большим числом коротких операций важнее задержка и стабильность. Исправление, которое улучшило большой iperf-поток, нельзя автоматически считать улучшением базы данных. Нужно измерить пользовательскую операцию с сопоставимым числом клиентов и объёмом данных.
TCP зависит также от доступного окна и задержки пути. Условная линия 25 Гбит/с при RTT 0,5 миллисекунды имеет произведение полосы на задержку около 1,56 МБ. При RTT 50 миллисекунд это уже около 156,25 МБ. Для локальной стойки второй режим обычно не является целью, но пример показывает, почему результаты удалённого теста нельзя напрямую переносить на серверную LAN. Ограничения окна, потери и повторные передачи могут снижать полезную скорость при исправном физическом линке.
SR-IOV или passthrough сетевой карты иногда выбирают ради конкретной нагрузки. При этом меняется управление доступом к устройству и могут появляться ограничения миграции, мониторинга и совместимости. Это нужно оценивать как отдельный вариант эксплуатации. Если обычный VirtIO-тракт уже выполняет требование, усложнять каждую ВМ прямым доступом к карте необязательно. Главный критерий — воспроизводимый результат приложения вместе с нужной процедурой обслуживания.
Практический порядок настройки такой: рабочий драйвер, базовый мост и MTU, измерение хост–хост, затем измерение гостя, после этого изменение одной гипотезы. Если добавили очереди, повторите ту же нагрузку и проверьте влияние на соседние ВМ. Если изменили расположение ресурсов, убедитесь, что узел сохранил достаточный запас для обычной работы. Оптимизация одной машины не должна незаметно ухудшать время ответа остальных пользователей.
Пример расчёта: где трём узлам хватает 25G, а где возникает перегрузка?
Рассмотрим отдельную расчётную ситуацию. У каждого из трёх хостов один активный 25G-путь; второй порт используется для резерва. Команда оценила одновременно исходящие потоки одного узла так: 6 Гбит/с от ВМ к пользователям, 8 Гбит/с к системе хранения и 4 Гбит/с к репозиторию резервного копирования. Все числа здесь исходные условия примера. Их нужно заменить собственными наблюдениями, сохранив направления и одновременность.
Обычный суммарный поток получается 18 Гбит/с на узел. Арифметический остаток до 25G равен 7 Гбит/с, но он не весь доступен приложению. Если добавить миграцию с предполагаемыми 6 Гбит/с на том же направлении, сумма вырастет до 24 Гбит/с. Доступного запаса почти не останется. Даже до практического теста понятно, что одновременный полный backup и миграция требуют ограничения нагрузки либо другого сетевого бюджета.
Теперь посмотрим на получателей. Три узла отправляют в storage суммарно 24 Гбит/с. Если хранилище подключено одним 25G-портом, оно почти заполняется этой нагрузкой и не получает полноценного резерва на служебный обмен и всплески. Репозиторий принимает 12 Гбит/с и по одной только полосе выглядит свободнее. Внешний uplink получает 18 Гбит/с пользовательского обмена. Эти три направления нельзя заменить одной красивой суммой коммутационной ёмкости CRS.
| Участок | Расчётный исходящий / входящий поток | Вывод для примера |
|---|---|---|
| Один хост в обычном режиме | 6 + 8 + 4 = 18 Гбит/с исходящего | Проверить запас и реальную полезную скорость |
| Хост во время миграции | 18 + 6 = 24 Гбит/с исходящего | Разнести задачи либо выделить отдельный ресурс |
| Вход хранилища от трёх хостов | 3 × 8 = 24 Гбит/с | Один 25G-порт становится тесным общим участком |
| Вход backup-репозитория | 3 × 4 = 12 Гбит/с | Проверить диски, CPU и время восстановления |
| Uplink пользовательских данных | 3 × 6 = 18 Гбит/с | Нужен запас и проверка маршрутизирующего устройства |
При потере одного вычислительного узла предположим равномерное распределение его нагрузки на оставшиеся два. Для сохранения того же общего объёма работы каждый теперь получает в 1,5 раза больше. Пользовательский поток становится 9 Гбит/с, обмен с хранилищем — 12 Гбит/с, резервное копирование при сохранении общей задачи — 6 Гбит/с. Сумма 27 Гбит/с уже превышает номинал одного 25G-пути. Два исправных сервера поэтому ещё не означают выполнение требования N+1 по сети.
Если на аварийный период остановить backup, останется 21 Гбит/с на узел до накладных расходов. Теперь появляется некоторый резерв, но восстановление хранилища может его занять. Значит, решение зависит от допустимого режима сервиса: можно ли временно ограничить фоновые задачи, снизить пользовательскую нагрузку или требуется полное сохранение производительности. В последнем случае рассматривают более быстрый активный путь, отдельные интерфейсы storage либо другую схему распределения потоков.
Сетевая карта с двумя портами не решает эту задачу автоматически. Active-backup оставит один активный 25G-канал, а LACP распределит потоки при подходящей конфигурации, но не гарантирует ускорение каждого отдельного соединения. Если перегружен один порт хранилища, добавление второго порта только хостам тоже не устранит общий предел. Менять нужно тот участок, который ограничивает требуемый режим, и проверять оба направления обмена после изменения.
Посчитаем отдельно физические подключения расширенной схемы. Три хоста, одно хранилище, один backup-сервер и один upstream-узел получают по одному пути к двум коммутаторам. Это шесть подключаемых устройств и двенадцать линий, по шесть портов на каждом CRS. Если на каждом CRS восемь SFP28, останется по два свободных. Две дополнительные межкоммутаторные линии 100G займут обе QSFP28-позиции каждого CRS510. Их нельзя одновременно обещать как свободные порты для другого 100G-устройства.
В таком варианте понадобится четырнадцать кабельных сборок: двенадцать оконечных и две межкоммутаторные. Это портовая ведомость, а не готовая настройка MLAG или гарантия устойчивости. Для оптики вместо готовых сборок отдельно считают трансиверы и трассы. Если upstream имеет другую скорость или отдельное устройство только с одним портом, ведомость изменится. Поэтому окончательный список закупки строят по реальным соединениям, с отметкой каждого занятого разъёма.
Из расчёта удобно получить критерии приёмки. Для обычного режима проверяют выбранные 18 Гбит/с на узел вместе с задержкой нужного приложения. Для обслуживания проверяют согласованное сочетание миграции и фоновых задач. Для отказа узла задают допустимую деградацию и проверяют оставшиеся каналы. Если один из режимов не помещается в расчёт, не стоит ждать, что реальная сеть исправит арифметику. Условия эксплуатации или состав оборудования нужно изменить до запуска.
Наконец, сравните разовую проверку с наблюдением за рабочим расписанием. Нагрузка бывает неоднородной: один клиент отправляет большой файл, два узла одновременно обновляются, хранилище выполняет внутреннее обслуживание. Среднее за пять минут может скрыть краткую, но ощутимую перегрузку. Сохраняйте графики с подходящим шагом и сопоставляйте их со временем жалоб. Это позволяет обоснованно выбрать момент следующего расширения сети и не покупать оборудование по одному случайному пику.
Почему средняя загрузка порта низкая, а задержка всё равно растёт?
Несколько серверов могут отправить данные одновременно в один более медленный выход. Представим три источника по 25G, которые на короткое время обращаются к одному 25G-получателю. Суммарно на вход предлагается 75 Гбит/с, на выходе доступно 25 Гбит/с. Разность 50 Гбит/с должна временно накапливаться в очереди либо теряться после исчерпания доступного буфера. Через секунду поток может прекратиться, и средний график будет выглядеть спокойным. Это не отменяет уже возникшую задержку.
За условные 0,2 миллисекунды такой разности накопилось бы 1,25 МБ данных. Это расчёт необходимого накопления при заданном потоке, не характеристика буфера конкретного CRS. Реальное распределение памяти и механизм обработки перегрузки зависят от оборудования и настроек. Нельзя обещать отсутствие потерь, просто сравнив эту величину с большим суммарным числом памяти в спецификации. Управляющая оперативная память коммутатора и доступный пакетный буфер выполняют разные задачи.
Очередь влияет и на короткие запросы, которые пришли после большого потока. Условные 10 МБ перед выходом 25G требуют около 3,2 миллисекунды только на последовательную передачу этого объёма без накладных расходов. Для приложения, которое делает много зависимых обращений подряд, дополнительные ожидания могут складываться. Поэтому проверка «в среднем занято меньше половины порта» недостаточна. Нужны наблюдение за очередями, счётчики отбрасываний и измерение времени операции одновременно с тяжёлым обменом.
Первое решение часто связано с самим распределением нагрузки. Можно разнести начало резервных копий по времени, ограничить параллельность отправителей, увеличить скорость общего получателя или выделить отдельный путь для массового копирования. Выбор зависит от того, какой режим допустим для сервиса. Изменять буферы и управление потоками вслепую не стоит: большая очередь способна уменьшить видимые потери ценой увеличения задержки. Техническое требование должно описывать оба показателя, а затем подтверждаться одним воспроизводимым сценарием проверки.
Почему линк 25G работает медленно или периодически пропадает?
Разбирайте проблему сверху вниз только после проверки физического слоя. Начните с фактической скорости порта и стабильности линка, затем посмотрите ошибки, FEC, температуру модулей и состояние PCIe. После этого переходите к bridge, VLAN, bond, маршрутам и приложению. Если одна и та же ошибка сохраняется на двух разных ВМ, но исчезает при замене DAC, менять параметры виртуальных адаптеров уже не первый шаг.
Сохраните исходные счётчики и сравнивайте их после каждого опыта. Большое накопленное число ошибок без времени наблюдения мало что объясняет: они могли появиться до замены кабеля. Полезнее записать приращение за 60 секунд нагрузки и проверить повторяемость. Одновременно фиксируют версию драйвера, firmware сетевой карты, RouterOS и идентификатор кабеля. Без этого два теста на «той же конфигурации» могут фактически относиться к разным условиям.
| Симптом | Возможный участок | Следующая проверка |
|---|---|---|
| Линка нет совсем | Скорость, тип модуля, FEC, кабель | Поддерживаемая комбинация на обоих концах, заведомо исправная сборка |
| Линк поднимается и падает | Качество линии, питание, перегрев | Ошибки, температура, замена кабеля или модуля |
| Хост доступен, ВМ недоступна | VLAN tag, bridge, гостевая ОС | Один тестовый VLAN и путь до шлюза |
| Связь есть только внутри хоста | Физический trunk или порт CRS | Тест между двумя разными физическими серверами |
| Малые пакеты проходят, большие операции зависают | MTU и фильтрация служебного обмена | Проверка размера с запретом фрагментации по всему пути |
| Один поток медленный, несколько быстрее | CPU, очереди, хеширование, приложение | CPU по ядрам, RSS, версия iperf3 и сравнение с ВМ |
| После отказа uplink bond не переключился | Контроль видит только локальный carrier | Схема обнаружения удалённого отказа и реальная достижимость |
| Медленно только при backup или recovery | Общая полоса, очереди, диски | Одновременные потоки, задержка, ограничение фоновой задачи |
Для первичной диагностики Linux пригодятся ip -br link, ip -br addr, ip route, bridge vlan show и ethtool. Информацию о драйвере получают через ethtool -i, сетевые счётчики — через доступные для адаптера средства статистики. На стороне MikroTik смотрят monitor соответствующего Ethernet-интерфейса, bridge ports и VLAN table. Смысл команд — сравнить реальную картину с планом, а не собрать длинный журнал без вопроса, на который он отвечает.
Не отключайте подряд все offload-функции ради поиска «честной скорости». Это может существенно изменить нагрузку CPU и создать новую проблему. Для проверки конкретной гипотезы меняют один параметр, сохраняют исходное значение и повторяют тот же тест. То же относится к autonegotiation, FEC и MTU. Если одновременно заменить кабель, включить jumbo и изменить драйвер, устойчивый результат появится, но вы не узнаете, какое изменение действительно помогло.
Какие отказы проверить до переноса рабочих ВМ?
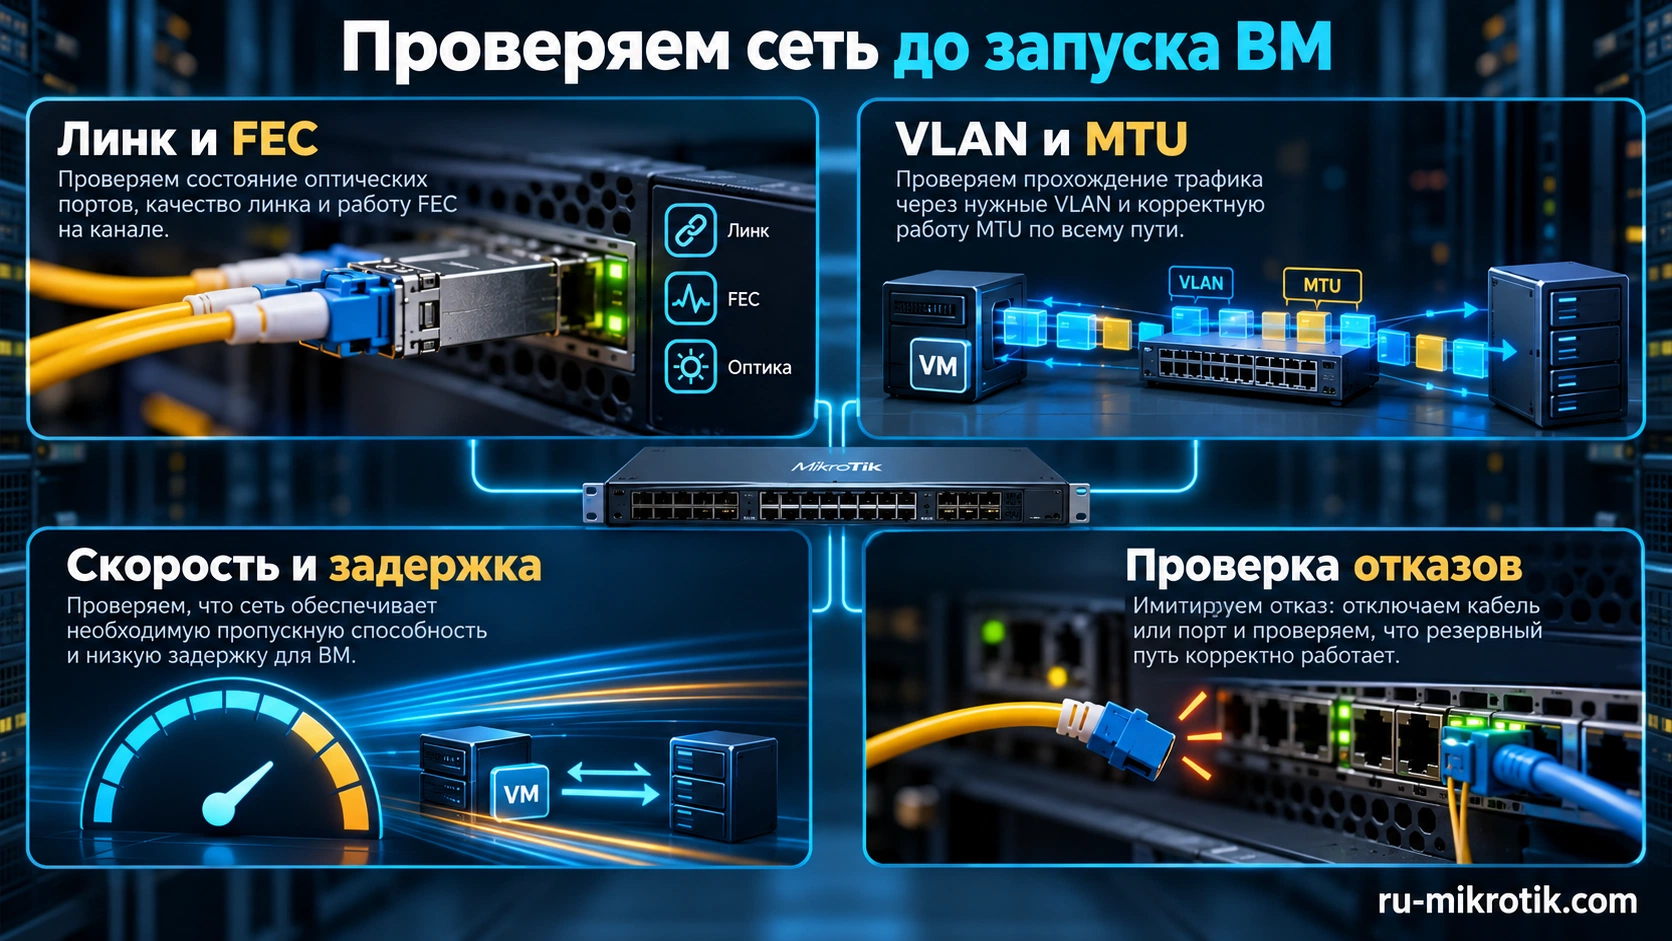
Программа приёмки начинается с рабочего тестового приложения и непрерывного наблюдения его доступности. Затем по очереди моделируют предусмотренные проектом отказы. Простое извлечение кабеля проверяет только один сценарий. Дополнительно нужны отключение порта на коммутаторе, потеря uplink, выключение одного CRS при наличии второго, потеря одного источника питания и обслуживание одного сервера. Полную программу согласуют так, чтобы эксперимент не затронул действующую инфраструктуру.
Для каждого опыта записывают время события, изменение сетевого состояния, продолжительность перерыва приложения и способ восстановления. Ping может продолжать отвечать, пока клиент базы данных теряет сессию. Или наоборот: несколько ICMP-пакетов потеряны, но приложение успешно повторило операцию и пользователь ничего не заметил. Критерии приёмки должны соответствовать сервису. Одно универсальное число «не больше одной секунды» без выбранного приложения и режима мало что значит.
Отдельно проверяют возвращение в штатное состояние. После включения коммутатора обратно не должны появляться петля, дубли адресов, неожиданная смена активного пути или повторная длительная пауза. Для LACP и MLAG наблюдают состояние агрегаторов и peer-link. Для active-backup — фактический активный участник и доступность всех нужных сегментов. Возврат основного пути иногда требует не меньше внимания, чем сам отказ.
Проверка питания имеет смысл только при независимых цепях. Два блока питания, включённые в один PDU, защищают от части отказов БП, но не от отключения этого распределителя. Запишите, какой кабель куда подключён и как питаются оба коммутатора. Сервер и его резервный сетевой путь не должны зависеть от одной случайно выключенной розетки, если проект требует переживать такой отказ. При обслуживании маркировка должна быть понятна человеку, который не собирал стойку.
Нагрузка во время теста тоже важна. Отказ на пустой сети может пройти незаметно, а тот же отказ во время восстановления Ceph перегрузит оставшийся канал. Проверяйте тяжёлое сочетание, которое допускает ваше расписание: рабочие ВМ плюс backup, миграция либо recovery. Результат нужен для решения, достаточно ли оставшейся полосы. Резервный путь меньшей скорости допустим, если его деградированный режим заранее описан и устраивает владельца сервиса.
Если проект включает кластерный перезапуск ВМ, проведите такой тест отдельно от сетевого переключения. Убедитесь, что у оставшихся хостов хватает ресурсов, хранилище доступно и приложение запускается. Этот сценарий уже выходит за пределы проверки одного коммутатора. Он показывает, что все части проекта согласованы. Запуск двух копий ВМ с одним диском или ручное обходное изменение кворума не должен становиться импровизированным способом «починить сеть».
Когда для Supermicro и MikroTik действительно нужен 100G или 400G?
100G полезен, когда несколько быстрых серверов сходятся к одному ресурсу или межкоммутаторной связи. Например, четыре активных источника по 25G в сумме могут предложить 100 Гбит/с. Но это только портовая арифметика: профиль потока и запас нужно учитывать отдельно. Если все четыре источника редко работают одновременно, более низкая скорость uplink может быть осмысленной. Если одновременная полная нагрузка обязательна, перегрузку нельзя скрывать надеждой на неполную занятость.
400G относится к следующему классу задач: высокоскоростная агрегация, некоторые GPU-кластеры и большие потоки между вычислениями и хранением. Компактный MikroTik CRS804-4DDQ-hRM имеет четыре QSFP56-DD 400G. Это позволяет рассматривать быстрый Ethernet вне крупных модульных шасси, но не делает любой сервер Supermicro готовым к 400G. Проверяются адаптер, PCIe, CPU, память, физические режимы линии и способ обмена приложения.
Свежий обзор ServeTheHome «Cheap Desktop 400GbE MikroTik CRS804», опубликованный 3 сентября 2026 года, полезен для постановки именно этих вопросов. В нём рассматриваются оборудование, оптика, управление и работа такой сети в окружении локальных ИИ-кластеров. При выборе сети Proxmox интереснее перенести этот подход к проверке всего тракта, чем купить максимальную скорость из заголовка. Локальная виртуальная инфраструктура с 25G и небольшой загрузкой не получает обязательной причины перейти на 400G.
Команда ServeTheHome описывает свой опыт словами: «Нам удалось запустить NCCL и RDMA через этот коммутатор». Это перевод короткой цитаты об их конфигурации. Работа RDMA в конкретном стенде не доказывает готовность произвольной пары Supermicro и MikroTik к такому же режиму. Нужны совместимые адаптеры, драйверы, поддерживаемый протокол, согласованные настройки и проверки приложения. Обычный TCP-тест не измеряет автоматически производительность NCCL или задержку RDMA.
Различайте Ethernet, InfiniBand и NVLink. Маркировка быстрой сетевой карты не делает её порт совместимым с любым из этих протоколов. Для VPI-адаптера проверяют выбранный режим, а для Ethernet-сети — именно поддержку Ethernet на обоих концах. NVLink внутри вычислительной системы имеет другую роль. Если приложение требует специальную межGPU-связь, один Ethernet-коммутатор не заменяет её свойства. Эти вопросы нужно решить до составления кабельной спецификации.
У 400G дополнительно усложняется физическая совместимость. QSFP56-DD, QSFP112 и OSFP могут относиться к одинаковой итоговой скорости при разной конструкции и электрических линиях. Нельзя заказать модуль только по числу 400. Для breakout проверяют поддерживаемый режим порта, число линий, скорость каждой линии, тип сборки и противоположные интерфейсы. Простое деление 400 на четыре не подтверждает совместимость произвольных четырёх 100G-адаптеров с выбранным кабелем.
Оцените и интерфейс PCIe. У PCIe 4.0 x16 после кодирования получается примерно 252 Гбит/с в одном направлении до остальных накладных расходов, у PCIe 5.0 x16 — около 504 Гбит/с. Поэтому для одного 400G-потока возможности поколения и ширины шины принципиальны. При двухпортовой карте общий сетевой номинал может превосходить пропускную способность её подключения к CPU. Это нормально для некоторых профилей нагрузки, но должно быть осознанным ограничением.
Переходить по этапам часто практичнее. Сначала проверенная сеть 25G на хостах, затем 100G на агрегации и только после появления измеримого требования — отдельный высокоскоростной контур. В комментариях к свежему обзору зритель @MH-qz9bm написал: «Я наконец-то обновил всё с Gigabit Ethernet до 2,5/5/10 Гбит/с…». Эта короткая реплика хорошо передаёт реальный выбор многих команд: поколение оборудования меняется быстрее, чем заканчивается полезный срок работающей сети. План обновления стоит привязывать к нагрузке и окнам обслуживания.
Что включить в заказ MikroTik и Supermicro для готового комплекта?
Спецификация должна описывать соединения, а не только основные коробки. Для базовой сети из трёх узлов укажите серверные платформы, точные сетевые карты, райзеры, планки, кабели, коммутатор и его питание. Для расширенного варианта добавляются второй CRS, вторые пути хостов и межкоммутаторные линии. Отдельно учитывают существующий шлюз: серверная агрегация 25G не означает, что весь интернет- или межсегментный трафик проходит с той же скоростью.
В качестве отправной точки для компактной 25G-сети можно проверить MikroTik CRS510-8XS-2XQ-IN. В заказе рядом с ним должны стоять артикулы всех DAC или оптических сборок и схема использования SFP28/QSFP28. Если сегодня задействованы только три сервера, отметьте, какие порты сохраняются для хранилища, backup и второго коммутатора. Запас становится полезным, когда закреплён за понятным будущим подключением.
Со стороны сервера можно рассмотреть, например, плату Supermicro H13SSL-NT с подходящей системой и дополнительной 25G-картой. Сама H13SSL-NT относится к форм-фактору ATX и предоставляет встроенные 10GBase-T, поэтому плату, шасси и оптическое подключение подбирают раздельно. Для выбора 25G-варианта есть Supermicro AOC-S25G-m2S-O; это другая модель, чем упомянутая выше AOC-S25G-b2S, с другим контроллером. Подмена одной буквы в артикуле может изменить драйвер и проверяемый список совместимости.
Техническую заявку на серверы и комплектующие можно направить через сайт официального поставщика Supermicro. В ней стоит объединить платформу, карту, райзер, кабели и требуемый сценарий Proxmox, чтобы получить согласованный состав. Уточняйте совместимость конкретного комплекта и условия поставки. Название производителя не заменяет согласованный артикул, а устное «для виртуализации подойдёт» не описывает сеть, запасные части и порядок приёмки.
| Позиция | Базовый пример на три узла | Что уточнить |
|---|---|---|
| Серверы | 3 платформы с выбранной конфигурацией | CPU, память, storage, питание, поддерживаемые карты |
| Сетевые карты | 3 двухпортовые 25G-карты, если нет нужных встроенных портов | Контроллер, PCIe, райзер, планка, firmware |
| Быстрый коммутатор | 1 CRS510 для начального варианта | Единственная точка отказа; второй CRS для требуемого резерва |
| Серверные кабели | 3 линии при одном порте на узел; 6 при двух | Артикул, длина, совместимость обоих концов |
| Межкоммутаторные линии | По выбранной схеме, отдельно от серверных | Режим, полоса, резерв, ограничения MLAG |
| Служебная сеть | Интерфейсы и порты для Corosync и BMC | Физическая независимость и доступ при аварии |
| Приёмка | Проверки линков, VLAN, нагрузки и отказов | Критерии, протокол, возврат исходной конфигурации |
Цена проекта складывается также из времени настройки и сопровождения. Иногда более простая сеть с отдельным management и понятным active-backup обходится в эксплуатации лучше сложной схемы, которую никто в команде не умеет восстанавливать. В другом случае дополнительные карты и коммутатор уменьшают неприемлемый простой. Выбирать стоит по стоимости требуемого режима работы, доступным компетенциям и проверяемой процедуре восстановления, а не только по стоимости одного гигабита.
Как внедрить сеть поэтапно и сохранить возможность отката?
До изменений сохраните конфигурации коммутаторов и хостов, схему адресов, текущие версии ПО и расположение кабелей. Экспорт RouterOS и резервная копия его настроек имеют разное назначение; сохранённые файлы должны быть доступны вне перенастраиваемой системы. Для Proxmox нужен исходный interfaces и связанные настройки. Дополнительно запишите, как открыть консоль каждого сервера через BMC. Наличие ссылки на BMC в старом чате не заменяет проверенного доступа.
Первый этап выполняют на одном освобождённом хосте и тестовой ВМ. Проверяют физическую линию, management, trunk, гостевую сеть и маршрутизацию. Затем добавляют миграцию и storage, после этого — нагрузку и резервирование. Каждый этап заканчивается понятным результатом и сохранённой конфигурацией. Такой порядок позволяет вернуться на последний рабочий шаг, если после включения новой функции появилось отклонение.
Перед переносом рабочих машин сравните мосты и VLAN всех трёх узлов. Проверьте, что DNS, NTP и доступ к нужным сервисам работают через новую сеть. Затем перенесите некритичный сервис и наблюдайте обычный рабочий цикл вместе с резервным копированием. Успешные пять минут после запуска не проверяют ночную нагрузку. Продолжительность наблюдения выбирают по реальному расписанию, а не по удобству завершить монтаж в тот же день.
Откат должен содержать конкретные действия: какие кабели вернуть, какой файл восстановить, какой интерфейс включить и как убедиться, что старый маршрут снова работает. Отдельно определите момент, после которого откат затрагивает данные, а не только сеть. Например, перенос хранилища и изменение доступа к дискам могут требовать иной процедуры, чем возвращение VLAN. Не смешивайте в одном неподготовленном окне сетевую переделку, обновление firmware и миграцию всех дисков.
После внедрения оставьте короткий рабочий документ: портовая карта, VLAN/IP-план, перечень версий, таблица проверенных кабелей, результаты тестов, аварийные действия и контакты ответственных. Для дальнейшего расширения полезна исходная загрузка портов и задержка приложений. Тогда покупка следующего 25G- или 100G-компонента будет опираться на наблюдаемое ограничение, а не на впечатление, что «сеть стала медленной». Это также помогает отличить рост нагрузки от неисправности.
Что контролировать после запуска серверной сети?
Сохраните исходную картину работы в обычный день: загрузку каждого направления, частоту ошибок, температуру доступных для наблюдения компонентов и задержку приложения. Названия портов в системе мониторинга должны совпадать с портовой ведомостью. Тогда предупреждение о PVE2 не придётся переводить в физический кабель по памяти. Для агрегированного интерфейса полезно видеть как общий обмен, так и отдельных участников: нормальная сумма способна скрывать выпадение одного из них.
Ошибки оценивают за интервал и сопоставляют с событиями. После перезапуска устройства накопленные счётчики могут обнулиться, поэтому их прямое вычитание из прежних значений даст неверный результат. Рост ошибок после смены модуля, изменение активного участника bond и потеря линка должны иметь отметку времени. Если жалоба пользователя пришла позже, история поможет найти совпадение. Единственный снимок текущего состояния уже восстановившейся сети часто не объясняет краткий ночной сбой.
Порог загрузки выбирают под требование сервиса и шаг измерения. Для массового копирования высокая занятость канала может быть нормальной, пока оно укладывается в окно и не мешает другим задачам. Для интерактивной системы поводом для проверки бывает рост задержки при вполне умеренной средней полосе. Уведомления должны различать доступность, производительность и состояние резерва. Работающая сеть с потерянным вторым путём уже требует внимания, хотя пользователи пока ничего не заметили.
После обновления драйвера, RouterOS, firmware адаптера или схемы VLAN повторяйте те проверки, которых изменение могло коснуться. Полную программу отключений не обязательно выполнять при каждой мелкой правке, но проверку резервного пути нельзя навсегда оставить в акте первого монтажа. Перед плановым обслуживанием убедитесь, что он по-прежнему доступен. Записывайте изменение и результат рядом: это позволит следующему администратору отличить известное ограничение от новой неисправности.
Доступ мониторинга к управлению коммутаторами и хостами ограничивают необходимыми адресами и правами. Диагностический сервис не должен неожиданно стать общедоступным входом в серверную сеть. Проверяйте также доставку самого уведомления и возможность открыть консоль при отказе основного пути. Если все журналы и средства наблюдения находятся на единственном недоступном хосте, в момент аварии исчезнет и часть нужной информации. Размещение наблюдения включают в тот же список зависимостей, что питание и коммутацию. Если вам сложно разобраться самостоятельно или нужна помощь, то вам помогут инженеры официального поставщика Supermicro в России и СНГ.
Частые вопросы о MikroTik, Supermicro и сети Proxmox
Можно ли подключить сервер Supermicro к MikroTik обычным кабелем RJ45?
Да, если оба выбранных порта Ethernet поддерживают подходящий медный режим и кабель соответствует расстоянию и скорости. Но RJ45 1G/10G на плате и SFP28 25G на коммутаторе — разные физические подключения. Для 25G обычно потребуется соответствующая карта и DAC либо оптическая линия. Проверяйте точные интерфейсы обоих устройств, а также назначение разъёма: отдельный IPMI относится к управлению сервером, не к пользовательскому обмену ВМ.
Нужен ли отдельный роутер для Proxmox, если есть CRS?
Нужна определённая роль шлюза между подсетями и внешними сетями. Её может выполнять подходящее устройство в существующей инфраструктуре. CRS способен иметь маршрутизирующие функции, но их производительность и аппаратное ускорение зависят от модели и режима. Не назначайте тяжёлую фильтрацию, NAT и хранение на один случайно выбранный программный путь. Сначала определите, какой поток требует маршрутизации и где должна находиться политика доступа.
Нужно ли ставить MikroTik CHR на сервер Supermicro для такой сети?
Для показанного VLAN trunk и Linux bridge установка CHR не обязательна. Физический MikroTik коммутирует кадры, Proxmox подключает ВМ к нужным сегментам, а назначенный шлюз обеспечивает маршрутизацию. CHR выбирают, когда требуется виртуальный RouterOS с конкретной задачей. Тогда отдельно решаются лицензия, ресурсы и доступность виртуального маршрутизатора при отказе хоста. Это самостоятельное архитектурное решение, которое не следует добавлять только ради сочетания двух брендов.
Хватит ли 10G для трёх узлов Proxmox?
Количество узлов само по себе ответа не даёт. При локальных дисках и умеренном пользовательском обмене 10G может оказаться достаточным. Быстрое общее хранилище, параллельные миграции и восстановление распределённых данных способны изменить требования. Сложите одновременные потоки на каждом узком участке и проверьте тяжёлый режим. При отказоустойчивой схеме полезная нагрузка должна помещаться и в оставшийся путь, иначе переключение сохранит линк, но не нужное качество работы.
Можно ли подключить 10G SFP+ карту к 25G SFP28-порту?
Это возможно у поддерживающей такой режим комбинации оборудования, но не гарантируется одной формой разъёма. Нужны совместимые скорость, кабель или модули и настройки обоих концов. Проверьте матрицы конкретного MikroTik и адаптера, затем поднимите именно 10G-линк. Временное подключение старого 10G-сервера к новой 25G-коммутации удобно для поэтапного обновления, если оно проверено заранее. Скорость старой карты от этого не вырастет до 25G.
Почему два порта по 25G не дают одному копированию 50G?
В active-backup работает один участник. В LACP потоки распределяются по хешу, и один обычный TCP-поток, как правило, остаётся на одном физическом канале. Суммарное преимущество появляется на нескольких подходящих потоках. Если приложение умеет многоканальный обмен, его возможности проверяют отдельно. Сравните один и несколько потоков тестового инструмента, затем реальное копирование. Требование ускорить один поток иногда означает переход на более быстрый порт, а не добавление второго такого же.
Нужен ли MLAG для двух коммутаторов MikroTik?
Не для любого проекта. Он нужен для определённой схемы распределённой агрегации, когда два устройства должны участвовать в согласованном подключении. Возможны также active-backup и отдельные маршрутизируемые сети. У каждого варианта свои условия и отказы. Если выбран MLAG, заранее проверьте peer-link, версии RouterOS, допустимые функции и поведение при потере синхронизации. Дополнительная сложность оправдана, когда она решает конкретное требование и команда умеет сопровождать такую схему.
Можно ли передавать Corosync через тот же 25G-порт, что и Ceph?
Логически такую сеть построить можно, но совместный физический путь требует контроля задержки и нагрузки. VLAN не защищает Corosync от очереди, которую создаёт интенсивный recovery. Выделенная физическая связь и дополнительный независимый link дают более понятную основу для устойчивости. Если приходится делить интерфейс, испытайте худшее допустимое сочетание потоков и потерю одного пути. Проверка только на пустом кластере не отвечает на вопрос о его поведении при восстановлении.
Обязательно ли создавать VLAN внутри каждой виртуальной машины?
Нет. Для обычной ВМ можно задать VLAN tag на виртуальном адаптере Proxmox и использовать внутри гостя обычный нетегированный интерфейс. Если гостевая система сама должна принимать trunk, например для специального сетевого приложения, конфигурация будет другой. Согласуйте один способ тегирования на выбранной границе. Случайное одновременное добавление одинакового тега в госте и на адаптере часто создаёт проблему, которую затем ошибочно ищут в физическом коммутаторе.
Нужно ли включать RDMA, PFC и jumbo frames для обычных ВМ?
Для обычной TCP/IP-сети виртуальных машин эти механизмы не являются обязательным стартовым набором. RDMA требует поддерживающего приложения и адаптеров, PFC относится к управлению определёнными классами трафика и требует отдельного проекта, jumbo frames согласуют по всему пути. Начните с рабочей базовой схемы и измерьте требование. Включение всех доступных функций одновременно усложняет диагностику и не гарантирует рост производительности конкретного сервиса.
Почему после миграции ВМ теряет сеть, хотя vmbr0 существует?
Имя моста должно соответствовать одинаковой физической сети на всех принимающих хостах. Проверьте разрешённые VLAN, привязку карты, tag ВМ и порт MikroTik. Возможна ситуация, когда vmbr0 на одном сервере ведёт в рабочий trunk, а на другом — в порт с иным списком VLAN. Также проверьте одинаковые параметры MTU и доступность шлюза. Тестовая миграция с контролем приложения обнаруживает такую ошибку до переноса критичных машин.
Можно ли использовать один коммутатор с двумя блоками питания для HA?
Два БП уменьшают зависимость от одного источника питания, если цепи организованы правильно. Отказ самой коммутационной системы, её ПО или необходимых портов они не устраняют. Для требования пережить потерю коммутатора нужен другой рабочий сетевой путь и проверяемое переключение. Уточняйте, что именно означает HA в проекте: сохранение сети, перезапуск ВМ, доступность хранилища или выполнение бизнес-операции. Эти требования проверяются разными сценариями.
Стоит ли сразу покупать 100G или 400G с запасом?
Запас полезен, если понятны будущие получатели, свободные PCIe-ресурсы, оптика и требуемая схема. Самый быстрый коммутатор не ускорит старый 10G-адаптер и не решит проблему медленных дисков. Иногда выгоднее подготовить трассы и выбрать 25G-карты, сохранив возможность быстрого uplink позже. Для специализированного GPU- или NVMe-контура высокая скорость может требоваться сразу. Решение принимают по измеренному обмену, сценарию отказа и стоимости всего комплекта.
Как понять, что ограничивает скорость: MikroTik или Supermicro?
Сравните несколько уровней: хост–хост через коммутатор, ВМ–ВМ на разных хостах и реальное приложение с дисками. Одновременно смотрите ошибки портов, CPU по ядрам, фактическую ширину PCIe и сетевые очереди. Если хостовый тест быстрый, а виртуальный заметно медленнее, исследуйте виртуальный тракт. Если сеть передаёт быстро, а дисковая операция медленно, проверяйте storage и протокол. Меняйте по одному условию, чтобы получить причину, а не случайное улучшение.
Какие данные отправить для подбора совместимого комплекта?
Нужны модели серверов и плат, CPU, свободные PCIe-слоты и райзеры, установленная ОС, число узлов, текущие карты и коммутаторы. Добавьте расстояния, типы кабелей, расположение хранилища, примерный одновременный обмен и допустимый простой. Если уже есть проблема, приложите версии ПО и результаты воспроизводимого теста. Такая заявка позволяет проверить конкретные артикулы и пути. Фраза «нужна мощная сеть для Proxmox» оставляет слишком много неизвестного для точного заказа.